
AI快速发展的今天,AI互连正从幕后配套走向台前,重塑传统算力产业格局。产业竞争焦点已从单颗芯片的峰值性能,转向算力如何被连接、调度与组织起来——当集群迈向万卡规模,带宽不足与延迟过高会让加速卡陷入“等数据”空转,峰值算力难以兑现为实际算力。于是互连成为AI系统效率的关键变量,从连接器件升级为资源组织的核心节点;开放与封闭两大阵营的标准之争,更在重新定义芯片协同的边界与整个产业的形态。
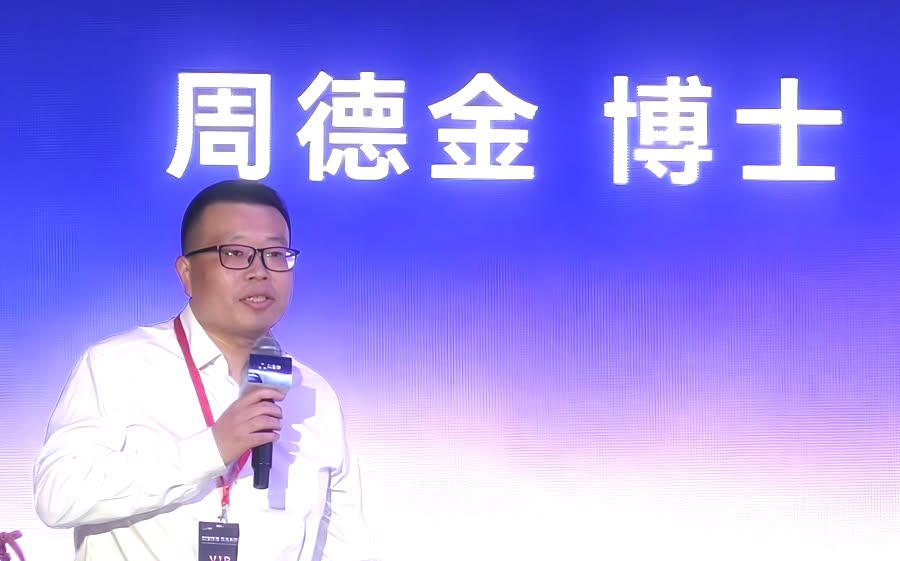
10月15日,在众星微召开的品牌及全栈产品发布会上,无锡市集成电路学会秘书长、清华大学无锡应用技术研究院IC平台主任周德金博士以“AI互连:系统创新重构算力产业新格局”为主题发表演讲,系统阐述了AI互连从技术演进到产业变革的内在逻辑,指出互连正在成为决定算力效率与产业格局的关键变量。
AI发展态势与范式演进
周德金认为,AI已进入加速发展阶段,这一阶段体现在算力、模型、应用和投资的同步扩张。在算力层面,参数规模与集群沿Scaling Law规律不断攀升,从千卡走向百万卡,推理与算力持续放大;在模型层面,大语言模型沿效率、记忆、感知、推理四大主线并行发展,正从语言模型进化到世界模型;在应用层面,从GPT到Agent再到机器人与自主系统,AI产业正从数字世界走向真实世界;在投资层面,四大云厂商资本开支从去年到今年增长约80%,2026年达7600亿美金,2027年迈向万亿。四条曲线同步向上,AI正处于加速扩张期,远未见顶。
谈及大语言模型的发展趋势,周德金指出其沿四条主线并进:规模上采用MoE稀疏激活架构,参数持续扩大而单次计算量降低,但带来更复杂的All-to-All通信,对AI互连提出新要求;记忆能力上,KV-Cache使模型从短文本走向长文本,对存储提出更高要求;感知能力上,多模态从文本扩展到图片、影音,衍生出世界模型;推理能力上,Test-time compute从文本依次推理转向多轮思考与多轮验证。四线并进逼近大语言模型边界,AI的下一站是理解真实世界。
周德金强调,从语言到世界模型开启了新范式。大语言模型阶段讲的是“应该生成什么”,世界模型阶段则要理解“世界怎样变化、动作之后产生什么变化”,其工作闭环涵盖感知、世界状态、预测与模拟、规划、行动。他以AMD宣布以82亿美金收购李飞飞创办的World Labs为例,说明这一事件虽尚未落地,却充分体现了全球最大玩家对世界模型的看法。由此,AI的影响正从数字智能走向物理智能——数字智能涵盖搜索、办公、编程,物理智能则指向机器人、无人驾驶、工业与生活机器人。范式的变化还体现在:大语言模型的训练主要存在于云端,而世界模型阶段的数据来源往往在终端,从终端返回云端再指导终端,形成云边端协同;从以训练为主转向“训练+推理”,本质是推动AI从中心训练走向“中心训练+泛载实时推理和反馈”。
从AI到芯片:增长的传导
AI驱动下全球半导体进入历史性扩张周期,集成电路增长非常快速。周德金指出,今年3月上海会议上预测集成电路世界销售规模为9000多亿美元,9月预测今年将超过1.5万亿美元,这可能是历史上最大的一次增幅。他认为,五年前大家对AI的理解会把AI与GPU划等号,近两年除GPU外HBM非常火热,从“算”扩展到“算和存”,如今又出现第三个核心——“传”,即AI互连。算、存、传、电、冷、感将成为支撑整个AI算力的核心要素。
与经济发展规律相似,算力规模扩张开始靠堆规模,越往后越向集约型发展,效率开始主导AI系统。Scaling Law决定了AI的上限能力,而效率决定了这些规模能兑现多少,系统效率成为当前和未来一段时间的约束。
周德金特别强调有效算力与理论算力的比值——MFU(模型浮点运算利用率),其值通常在30%至55%之间,很少有测试超过50%,意味着大部分算力在传输过程中被浪费。随着世界模型发展,数据传输浪费还包括传感器搬运、异步算力同步、语音编辑协同。AI越是从模型走向系统,系统效率越决定整体算力效率,而系统效率的提升更多集中在互连而非算力本身。因此,互连成为AI系统变化的变量——计算解决“计算得多快”,互连解决“数据何时、以什么代价到达哪里”,AI互连优化就是减少等待、搬运与同步,而非一味增加算力。
AI互连贯穿芯片、节点、机架、集群及数据中心的整个AI系统。在芯粒层面是Die-to-Die,主要协议为UCIe;节点和超节点(服务器内,含数千至上万颗芯片)涉及PCIe、CXL、NVLink及标准UALink;机架与机架之间的Scale-out达到万卡集群,涵盖IB、ROCE、UEC协议。周德金认为,这不是传统升级而是系统级流动架构,Scale-Up和Scale-Out是当前标准竞争的核心主战场。
AI互连:算力产业变革的核心
“AI互连自身在变化,AI范式也在反向定义下一代互连技术与产品”。周德金表示,LLM的发展(如MoE、长上下文)对Scale-Out组、CXL内存池化、拥塞控制提出极高要求;从大语言模型到世界模型,对高带宽Fabric进数据的计算、确定性时延、边缘互连及冗余设计也提出新要求。互连演进不是独立演进,而是被模型、应用所定义的技术发展和产品变化。
从历史看,二十年前互连主要解决设备接入,即主机与外设之间数据的进出;Switch时代解决一点到多点的数据分发;Fabric时代则组织计算、存储、加速与I/O资源,形成统一系统。AI时代对互连提出高带宽、低延迟、可扩展、可靠/QoS的更高要求,互连芯片从连接器件转变为AI系统中资源组织的节点,成为整个AI系统的核心组成部分。
周德金强调,互连标准是AI生态主导权之争的核心,也是我国AI实现系统突围的关键。英伟达不仅是GPU厂商,其NVLink互连、NVSwitch及IB标准构成了强大的封闭生态;国际上有PCIe、CXL、UCIe、UALink等开放组织,国内很多企业也参与其中,中国同时在探索自主开放的标准,以换取生态支持更多节点。由于在GPU上我国与国际存在代差,这一代差往往通过互连来补充和弥补。
从技术到产业的思考
在系统梳理AI发展态势、增长传导与互连变革之后,周德金进一步将视角从技术层面延伸至产业层面。他认为,AI互连的意义不止于技术突破,更在于其对整个算力产业格局的重构。基于此,他围绕AI互连的产业价值提出三点思考。
其一,从大语言模型走向世界模型,AI互连是核心。世界模型不是单一强化某一种芯片,而是推动CPU、GPU、FPGA、ASIC/NPU等异构算力架构以及算和存的重新分工,而异构计算与存算效率的提升核心在于数据如何去传,数据传输的核心就在于互连。
其二,从单点走向系统的主要约束。GPU峰值算力只是局部指标,任务完成时间与效率才决定AI系统真正价值,互连正是AI系统效率的第一约束力。
其三,从产品走向生态的战略布局。AI生态包括协议、芯片、软件、参考设计、测试认证和客户,生态位决定产业位,生态的核心在标准,而整个AI系统中的标准主要集中在互连。芯片决定单点能力,互连决定系统能力,标准影响产业边界。
“互连是当前算力发展及下一阶段AI产业的主要竞争点,是AI竞争的主战场。”周德金澄清说,这并不是说计算、存储或电力不重要。
展望未来,周德金认为AI互连的发展将沿多条主线持续推进:一方面,开放标准加速成熟,UALink、UEC、UCIe、CXL等开放协议有望打破封闭生态的垄断,推动多厂商芯粒拼接与内存解耦成为现实;另一方面,光互连与共封装光学(CPO)正从实验室走向数据中心,以满足百万卡集群的超低延迟与高带宽需求。对正处于从规模扩张迈向效率优化关键阶段的我国算力产业而言,这既是挑战也是机遇——凭借在光模块、开放标准与系统集成上的积累,中国有望以互连为支点缩小与先进水平的代差,在AI系统级竞争中占据更有利的位置。
【未经本人审定】
 mingzhiLatest posts by mingzhi (see all)